
Screaming Frog là công cụ crawl website được sử dụng để thu thập URL, kiểm tra lỗi kỹ thuật và phân tích các thành phần SEO trên từng trang. Công cụ giúp đội ngũ phát hiện liên kết hỏng, redirect, title trùng lặp, lỗi canonical, nội dung mỏng và nhiều vấn đề ảnh hưởng đến khả năng thu thập dữ liệu.
Phiên bản miễn phí phù hợp với website nhỏ vì cho phép crawl tối đa 500 URL trong mỗi lần chạy. Với dự án lớn hoặc cần JavaScript rendering, lưu dữ liệu crawl và tích hợp API, doanh nghiệp có thể cân nhắc phiên bản trả phí.
Screaming Frog là gì?
Screaming Frog thường được dùng để chỉ phần mềm Screaming Frog SEO Spider, một trình thu thập dữ liệu website hoạt động trên Windows, macOS và Linux. Công cụ mô phỏng cách bot di chuyển qua liên kết để thu thập URL và các thành phần SEO liên quan.
Theo nhà phát triển, SEO Spider có thể kiểm tra hàng trăm vấn đề, cảnh báo và cơ hội liên quan đến SEO, sức khỏe website và trải nghiệm người dùng. Dữ liệu được phân loại theo các khu vực như Internal, Response Codes, Page Titles, Meta Description, H1, Images, Canonicals và Directives.
Screaming Frog thường được dùng để:
- Audit Technical SEO.
- Tìm liên kết hỏng.
- Kiểm tra redirect.
- Phân tích title và Meta Description.
- Kiểm tra H1, H2.
- Phát hiện nội dung trùng lặp.
- Kiểm tra canonical.
- Rà soát noindex.
- Phân tích internal link.
- Kiểm tra hình ảnh thiếu alt.
- Tạo XML Sitemap.
- Kiểm tra dữ liệu có cấu trúc.
Screaming Frog hoạt động như thế nào?
Screaming Frog bắt đầu từ một URL được nhập vào, sau đó đi theo những liên kết mà công cụ phát hiện để thu thập thêm tài nguyên. Kết quả được cập nhật theo thời gian thực và hiển thị trong các tab tương ứng với từng nhóm dữ liệu.
Quy trình đơn giản gồm:
- Nhập tên miền hoặc URL bắt đầu.
- Công cụ gửi yêu cầu đến trang.
- Các liên kết nội bộ được phát hiện.
- URL mới được đưa vào hàng đợi.
- Dữ liệu SEO của từng URL được thu thập.
- Vấn đề được phân loại theo tab và bộ lọc.
- Người dùng xuất báo cáo để xử lý.
Screaming Frog không đánh giá chất lượng kinh doanh của nội dung theo cách con người thực hiện. Công cụ cung cấp dữ liệu và cảnh báo kỹ thuật; đội SEO vẫn phải kiểm tra ngữ cảnh trước khi quyết định chỉnh sửa.
Không phải mọi cảnh báo trong Screaming Frog đều là lỗi bắt buộc sửa. Một URL noindex, redirect hoặc thiếu Meta Description có thể được cấu hình có chủ đích tùy chức năng của trang.
Screaming Frog kiểm tra được những gì?
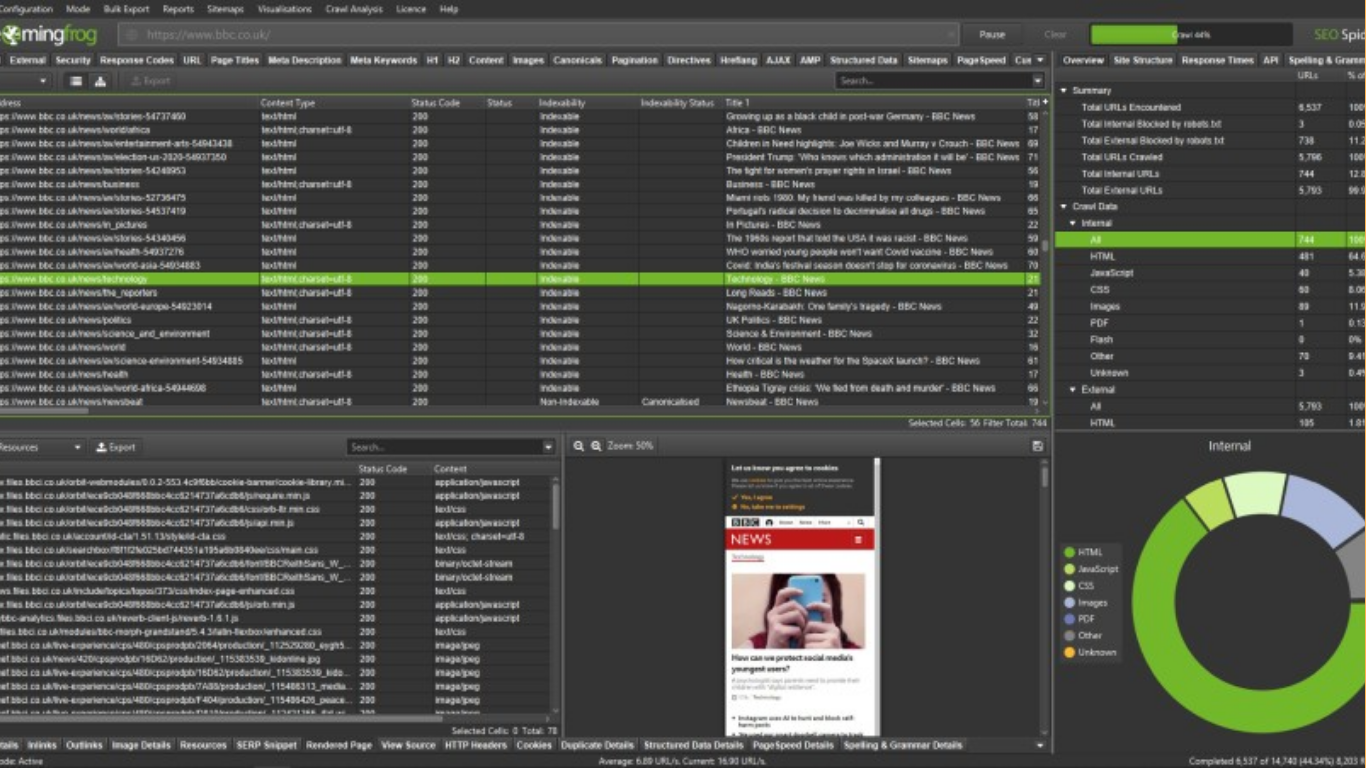
Screaming Frog có thể kiểm tra nhiều thành phần từ mã phản hồi, metadata, heading đến canonical, hreflang và structured data. Phạm vi kiểm tra còn phụ thuộc vào cấu hình crawl và phiên bản phần mềm.
| Nhóm kiểm tra | Vấn đề có thể phát hiện |
| Response Codes | 3xx, 4xx, 5xx |
| Page Titles | Thiếu, trùng, quá dài |
| Meta Description | Thiếu, trùng, độ dài chưa phù hợp |
| H1, H2 | Thiếu hoặc lặp lại |
| Images | Ảnh lỗi, thiếu alt, dung lượng lớn |
| Canonicals | Thiếu, trỏ sai hoặc không nhất quán |
| Directives | noindex, nofollow |
| Internal Links | Trang ít link, anchor và độ sâu |
| Content | Trùng lặp và gần trùng lặp |
| Structured Data | Lỗi cú pháp hoặc thuộc tính |
| Hreflang | Liên kết ngôn ngữ không hợp lệ |
| JavaScript | Nội dung cần rendering |
Trang giới thiệu chính thức liệt kê các tính năng như tìm broken link, phân tích metadata, kiểm tra robots và directives, audit hreflang, phát hiện nội dung trùng, kiểm tra structured data và tích hợp Google Analytics, Search Console cùng PageSpeed Insights.
Bản Screaming Frog miễn phí và trả phí khác nhau thế nào?
Phiên bản miễn phí cho phép crawl tối đa 500 URL trong một lần và phù hợp để kiểm tra website nhỏ hoặc làm quen với giao diện. Phiên bản trả phí loại bỏ giới hạn cố định này, nhưng số URL thực tế vẫn phụ thuộc vào bộ nhớ và dung lượng lưu trữ của thiết bị.
| Tiêu chí | Miễn phí | Trả phí |
| Giới hạn crawl | 500 URL | Không giới hạn cố định |
| Lưu và mở crawl | Hạn chế | Có |
| Cấu hình nâng cao | Hạn chế | Có |
| JavaScript rendering | Hạn chế | Có |
| Custom extraction | Hạn chế | Có |
| API integration | Hạn chế | Có |
| Lập lịch crawl | Không đầy đủ | Có |
| So sánh crawl | Hạn chế | Có |
Website có dưới 500 URL vẫn có thể cần bản trả phí nếu sử dụng nhiều tài nguyên, JavaScript rendering hoặc muốn lưu dữ liệu để so sánh giữa các lần audit.
Cách cài đặt Screaming Frog
Screaming Frog SEO Spider có phiên bản dành cho Windows, macOS và một số hệ điều hành Linux. Người dùng tải bộ cài từ website chính thức, mở tệp và thực hiện các bước cài đặt theo hệ điều hành.
Quy trình cơ bản:
- Truy cập trang Screaming Frog SEO Spider.
- Chọn hệ điều hành.
- Tải bộ cài.
- Mở tệp cài đặt.
- Hoàn thành các bước hướng dẫn.
- Khởi động phần mềm.
- Nhập licence nếu dùng bản trả phí.
- Bỏ qua bước kích hoạt nếu dùng bản miễn phí.
Trước khi crawl website lớn, nên kiểm tra dung lượng ổ đĩa và bộ nhớ. Thu thập nhiều URL, hình ảnh và dữ liệu JavaScript có thể tiêu tốn đáng kể tài nguyên máy tính.
Cách crawl website bằng Screaming Frog
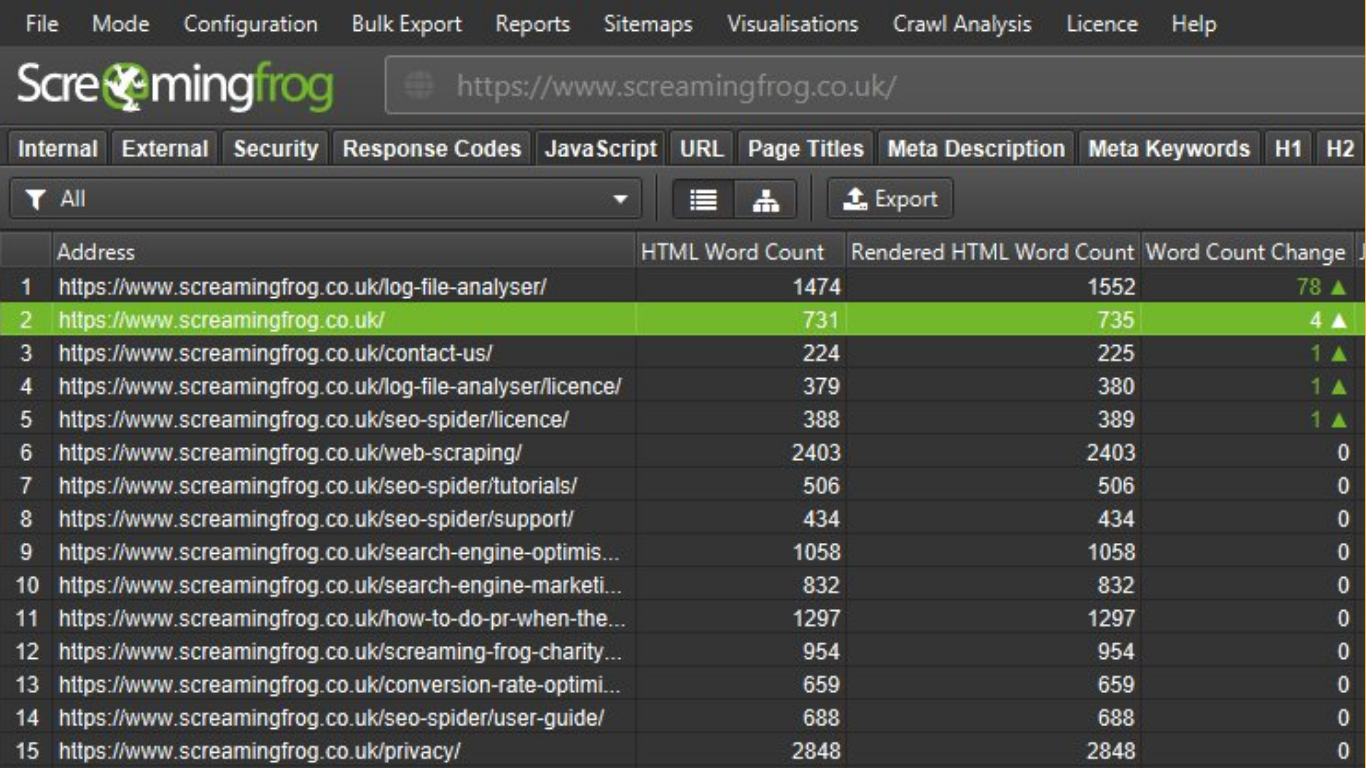
Để crawl một website, bạn nhập địa chỉ tên miền vào thanh trên cùng rồi chọn Start. Dữ liệu sẽ xuất hiện dần trong các tab khi công cụ phát hiện và xử lý URL.
Các bước thực hiện:
- Mở Screaming Frog SEO Spider.
- Chọn chế độ Spider.
- Nhập URL đầy đủ của website.
- Kiểm tra phạm vi crawl.
- Nhấn Start.
- Chờ tiến trình đạt 100%.
- Mở tab Overview.
- Kiểm tra từng nhóm lỗi.
- Xuất dữ liệu cần xử lý.
- Lưu crawl nếu phiên bản hỗ trợ.
Nên dùng đúng phiên bản giao thức và tên miền chuẩn, chẳng hạn HTTPS thay vì HTTP nếu website đang hoạt động trên HTTPS.
Cách đọc các tab quan trọng
Các tab của Screaming Frog phân chia dữ liệu theo từng nhóm SEO. Người mới nên bắt đầu với Internal, Response Codes, Page Titles, Meta Description, H1, Images, Canonicals và Directives.
Tab Internal
Internal hiển thị những URL và tài nguyên nội bộ được phát hiện trong lần crawl. Bạn có thể lọc theo HTML, JavaScript, CSS, hình ảnh hoặc loại tệp khác.
Các cột thường cần xem:
- Status Code.
- Indexability.
- Title.
- Meta Description.
- H1.
- Canonical.
- Crawl Depth.
- Inlinks.
- Word Count.
- Content Type.
Tab Response Codes
Tab này giúp phát hiện URL trả về mã phản hồi bất thường. Bộ lọc Client Error 4xx có thể được dùng để tìm trang 404, trong khi Redirection 3xx giúp kiểm tra URL chuyển hướng.
| Mã phản hồi | Ý nghĩa |
| 200 | Trang hoạt động bình thường |
| 301 | Chuyển hướng vĩnh viễn |
| 302 | Chuyển hướng tạm thời |
| 404 | Không tìm thấy trang |
| 500 | Lỗi phía máy chủ |
| 503 | Dịch vụ tạm thời không khả dụng |
Khi phát hiện 404, hãy chọn URL và mở phần Inlinks để xem những trang nào đang liên kết đến địa chỉ lỗi.
Tab Page Titles
Tab Page Titles giúp kiểm tra:
- Trang thiếu title.
- Title trùng nhau.
- Title quá ngắn.
- Title quá dài.
- Nhiều phần tử title.
- Title giống H1 nếu cần đánh giá.
Không nên sửa hàng loạt chỉ dựa vào cảnh báo độ dài. Tiêu đề cần được đánh giá thêm theo search intent và giá trị của từng URL.
Tab Meta Description
Tab này giúp phát hiện Meta Description bị thiếu hoặc lặp lại. Tuy nhiên, không phải URL nào cũng bắt buộc phải có mô tả viết thủ công.
Các trang quan trọng nên được ưu tiên:
- Trang dịch vụ.
- Trang sản phẩm.
- Trang danh mục.
- Bài viết có traffic.
- Landing page.
- Trang địa phương.
Tab H1 và H2
Screaming Frog thu thập heading để phát hiện trang thiếu H1 hoặc sử dụng nhiều H1. Kết quả này cần được kiểm tra trên giao diện thực tế vì một số website tạo heading bằng thành phần mẫu hoặc JavaScript.
Tab Images
Tab Images giúp tìm:
- Ảnh trả về lỗi.
- Ảnh thiếu alt text.
- Ảnh có dung lượng lớn.
- Ảnh được liên kết từ nhiều trang.
Cấu hình chính thức cho phép lựa chọn có lưu và crawl hình ảnh hay không. Nếu tắt crawl, hình ảnh trong phần tử img có thể không được kiểm tra mã phản hồi.
Cách kiểm tra robots.txt bằng Screaming Frog
Screaming Frog có thể tuân theo hoặc kiểm tra quy tắc trong robots.txt để xác định URL nào bị chặn crawl. Công cụ cũng hỗ trợ sử dụng custom robots.txt trong một số cấu hình nhằm thử nghiệm thay đổi trước khi triển khai thực tế.
Khi một trang không xuất hiện trong báo cáo, hãy kiểm tra:
- URL có được liên kết nội bộ không.
- robots.txt có chặn thư mục không.
- Trang có yêu cầu đăng nhập không.
- Link được tạo bằng JavaScript không.
- URL có nằm ngoài phạm vi crawl không.
- Công cụ có tuân theo nofollow không.
- Trang có được phát hiện qua sitemap không.
Bạn có thể đọc thêm bài robots.txt để hiểu cách tệp này điều khiển hoạt động crawl, cú pháp Disallow và những lỗi cấu hình có thể khiến nội dung quan trọng bị chặn.
Trước khi sửa robots.txt, hãy kiểm tra cả môi trường thử nghiệm và website thật. Một quy tắc chặn sai thư mục có thể khiến bot không truy cập được nhiều trang quan trọng.
Crawl JavaScript bằng Screaming Frog
Chế độ mặc định có thể tập trung vào HTML gốc, trong khi JavaScript rendering cho phép phần mềm thực thi JavaScript bằng trình duyệt headless và thu thập nội dung sau khi trang được render.
JavaScript rendering phù hợp khi website:
- Xây dựng bằng React, Vue hoặc Angular.
- Tải nội dung phía client.
- Tạo liên kết sau khi script chạy.
- Hiển thị sản phẩm bằng AJAX.
- Có sự khác biệt giữa HTML gốc và giao diện.
Crawl bằng JavaScript thường chậm hơn và sử dụng nhiều tài nguyên hơn. Không cần bật chế độ này cho mọi website nếu nội dung cùng liên kết đã có đầy đủ trong HTML ban đầu.
Screaming Frog hỗ trợ marketing như thế nào?
Screaming Frog chủ yếu là công cụ SEO kỹ thuật nhưng dữ liệu của nó có thể hỗ trợ nhiều hoạt động marketing. Website có cấu trúc tốt sẽ giúp nội dung, quảng cáo và landing page hoạt động ổn định hơn.
Một số ứng dụng thực tế:
- Kiểm tra landing page bị lỗi.
- Rà soát CTA dẫn đến URL 404.
- Phát hiện trang chiến dịch còn được index.
- Kiểm tra title của trang dịch vụ.
- Tìm hình ảnh thiếu alt.
- Xác định trang ít internal link.
- Audit website trước khi chạy quảng cáo.
- Kiểm tra redirect sau đổi tên sản phẩm.
- So sánh website trước và sau khi redesign.
- Thu thập URL để lập kế hoạch content.
Ví dụ, một chiến dịch có thể bị giảm hiệu quả nếu quảng cáo dẫn đến trang chuyển hướng nhiều bước hoặc landing page trả về lỗi máy chủ. Screaming Frog giúp phát hiện những vấn đề này trước khi ngân sách được phân phối rộng.
Quy trình audit website bằng Screaming Frog
Một quy trình audit nên đi từ khả năng crawl, index đến metadata, nội dung và internal link. Không nên bắt đầu sửa title khi website vẫn có lỗi máy chủ hoặc nhiều trang quan trọng bị chặn.
Thứ tự tham khảo:
- Kiểm tra phạm vi crawl.
- Xem mã phản hồi.
- Phát hiện 4xx và 5xx.
- Kiểm tra redirect chain.
- Rà soát indexability.
- Kiểm tra robots.txt.
- Phân tích canonical.
- Kiểm tra title và Meta Description.
- Rà soát H1.
- Tìm nội dung trùng.
- Phân tích internal link.
- Kiểm tra hình ảnh.
- Xuất danh sách lỗi.
- Xếp mức độ ưu tiên.
- Crawl lại sau khi sửa.
Kết luận
Screaming Frog là công cụ crawl và audit website giúp phát hiện lỗi mã phản hồi, metadata, canonical, robots.txt, internal link và nhiều vấn đề Technical SEO khác. Phiên bản miễn phí phù hợp với website nhỏ, trong khi bản trả phí hỗ trợ cấu hình và phân tích nâng cao.
Tandigi khuyến nghị doanh nghiệp dùng Screaming Frog theo quy trình ưu tiên từ khả năng crawl, index đến nội dung và trải nghiệm. Dữ liệu từ công cụ cần được kiểm tra trong bối cảnh thực tế trước khi sửa, đồng thời nên crawl lại để xác nhận lỗi đã được xử lý chính xác.
Thông tin liên hệ:
🏢 Địa chỉ: 02 Đường số 7, Khu Đô Thị Vạn Phúc- Tp.Thủ Đức
🌐 Website: https://tandigi.com
🌐 Fanpage: https://www.facebook.com/tandigiagency/
📩 Email: [email protected]
📞 Số điện thoại: 0908 364 575

Tân Nguyễn là CEO Tandigi, với hơn 15 năm kinh nghiệm trong lĩnh vực Digital Marketing. Anh đã tư vấn và triển khai chiến lược tiếp thị số cho hàng trăm doanh nghiệp trong và ngoài nước. Với tư duy chiến lược và sự am hiểu sâu sắc về thị trường, Tân Nguyễn là một trong những chuyên gia hàng đầu trong ngành.