
Robots txt là một file nhỏ nhưng có thể ảnh hưởng lớn đến cách Google thu thập dữ liệu website. Nếu cấu hình đúng, robots txt giúp bot tìm kiếm tập trung vào các trang quan trọng, hạn chế crawl URL rác và hỗ trợ tối ưu technical SEO. Nhưng nếu cấu hình sai, chỉ một dòng Disallow cũng có thể khiến website bị chặn crawl, ảnh hưởng đến index và traffic organic.
Robots TXT Là Gì?
Trước khi tối ưu, bạn cần hiểu đúng vai trò của robots txt. Đây không phải là công cụ “tăng top” trực tiếp, nhưng là một phần quan trọng trong cách công cụ tìm kiếm đọc website.
Robots txt, hay chính xác là file robots.txt, là một tệp văn bản nằm ở thư mục gốc của website. File này dùng để hướng dẫn các bot/crawler như Googlebot, Bingbot biết khu vực nào trên website được phép hoặc không được phép thu thập dữ liệu.
Ví dụ, file robots txt thường nằm tại đường dẫn:
https://domain.com/robots.txt
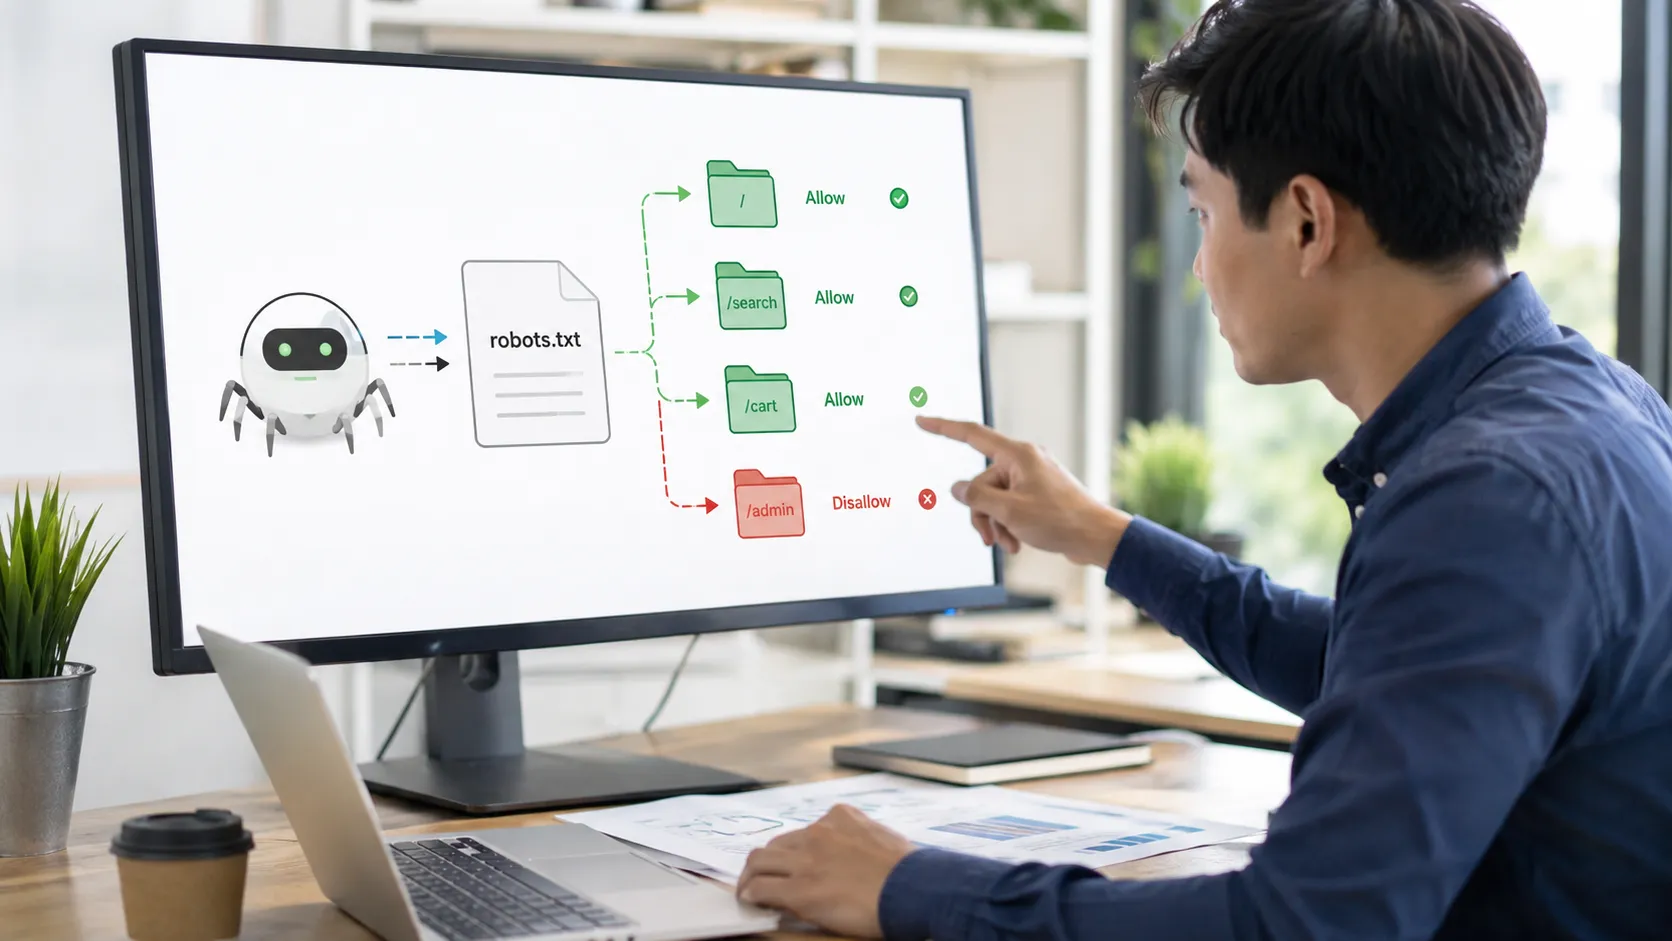
Nói đơn giản, robots txt giống như bảng hướng dẫn dành cho bot tìm kiếm. Khi Googlebot truy cập website, nó sẽ kiểm tra file này để biết nên crawl trang nào, thư mục nào cần bỏ qua và sitemap nằm ở đâu.
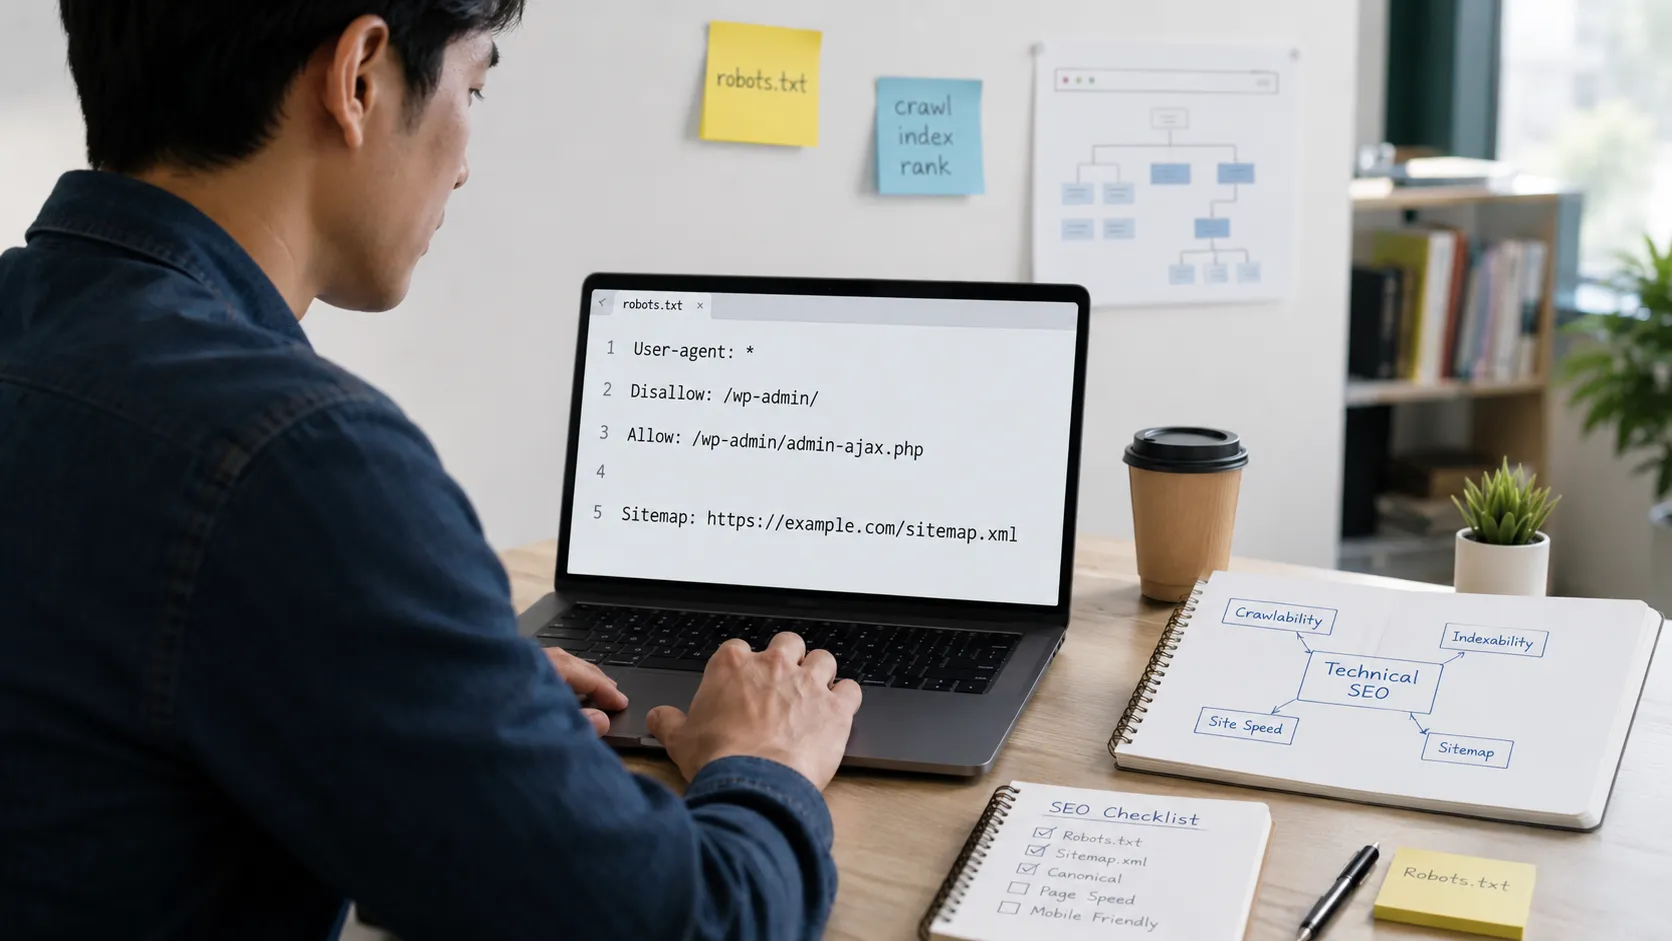
Một file robots txt cơ bản có thể như sau:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap.xml
Trong đó, User-agent xác định bot áp dụng quy tắc, Disallow chặn bot crawl một thư mục, Allow cho phép crawl một URL cụ thể, còn Sitemap khai báo vị trí sitemap XML.
Vì Sao Robots TXT Quan Trọng Trong SEO?
Robots txt không trực tiếp giúp website lên top, nhưng nó ảnh hưởng đến cách bot truy cập và hiểu cấu trúc website. Với website lớn, blog nhiều bài hoặc trang thương mại điện tử, file này càng quan trọng hơn.
Vai trò của robots txt trong SEO:
| Vai trò | Ý nghĩa với SEO |
| Kiểm soát crawling | Hướng bot đến các khu vực quan trọng |
| Tối ưu crawl budget | Giảm crawl các URL kém giá trị |
| Hạn chế URL rác | Tránh bot mất thời gian với trang filter, sort, search |
| Khai báo sitemap | Giúp bot tìm danh sách URL quan trọng nhanh hơn |
| Bảo vệ khu vực không cần crawl | Ví dụ admin, cart, checkout, staging |
Ví dụ, một website ecommerce có thể tạo ra hàng nghìn URL do bộ lọc màu sắc, kích thước, giá, sắp xếp sản phẩm. Nếu không kiểm soát, Googlebot có thể tốn crawl budget vào các URL ít giá trị thay vì sản phẩm, danh mục hoặc bài blog quan trọng phục vụ đúng target market. Đây là lúc robots txt phát huy tác dụng.
Tuy nhiên, cần nhớ: robots txt chủ yếu kiểm soát việc crawl, không phải công cụ chặn index tuyệt đối.
Cấu Trúc Cơ Bản Của File Robots.txt
Một file robots txt tốt không cần quá phức tạp. Quan trọng nhất là viết đúng cú pháp, đặt đúng vị trí và không chặn nhầm những URL quan trọng cần SEO.
Các thành phần phổ biến trong robots txt gồm:
| Thành phần | Chức năng |
| User-agent | Xác định bot/crawler áp dụng quy tắc |
| Disallow | Không cho bot crawl URL hoặc thư mục |
| Allow | Cho phép bot crawl URL cụ thể |
| Sitemap | Khai báo vị trí file sitemap.xml |
| Crawl-delay | Gợi ý bot crawl chậm hơn, nhưng Google không hỗ trợ lệnh này |
Ví dụ:
User-agent: *
Disallow: /admin/
Disallow: /search/
Sitemap: https://example.com/sitemap.xml
Trong ví dụ trên, User-agent: * nghĩa là áp dụng cho tất cả bot. Disallow: /admin/ yêu cầu bot không crawl thư mục admin. Disallow: /search/ giúp hạn chế bot crawl trang kết quả tìm kiếm nội bộ.
Với WordPress, mẫu robots txt phổ biến là:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap_index.xml
Lưu ý: không nên chặn toàn bộ /wp-content/ vì Google cần truy cập CSS, JS, hình ảnh để render và hiểu nội dung trang.
Robots.txt Có Chặn Index Không?
Đây là nhầm lẫn rất phổ biến. Nhiều người nghĩ rằng chỉ cần chặn một URL trong robots txt thì URL đó sẽ không xuất hiện trên Google. Thực tế không hoàn toàn như vậy.
Robots txt dùng để chặn crawl, không phải chặn index tuyệt đối. Nếu một URL bị chặn crawl nhưng vẫn có internal link hoặc backlink trỏ đến, Google vẫn có thể biết URL đó tồn tại. Trong một số trường hợp, URL vẫn có thể xuất hiện trên kết quả tìm kiếm nhưng không có mô tả đầy đủ.
So sánh nhanh:
| Tiêu chí | Robots.txt | Noindex |
| Mục đích chính | Kiểm soát bot crawl | Yêu cầu không lập chỉ mục |
| Có chặn index tuyệt đối không? | Không hoàn toàn | Có, nếu Google crawl được trang |
| Bot có đọc nội dung không? | Không, nếu bị chặn crawl | Có thể đọc để thấy thẻ noindex |
| Dùng khi nào? | Chặn URL kém giá trị khỏi crawling | Không muốn trang xuất hiện trên Google |
Nói đơn giản: nếu bạn không muốn Google crawl một khu vực, dùng robots txt. Nếu bạn không muốn một trang xuất hiện trên Google, hãy dùng noindex, x-robots-tag hoặc bảo vệ bằng mật khẩu với nội dung nhạy cảm.
Cách Tạo File Robots TXT Chuẩn SEO
Tạo robots txt không khó. Nhưng trước khi viết file, bạn cần biết rõ website của mình có những khu vực nào nên cho bot crawl và khu vực nào nên hạn chế.
Checklist tạo robots txt chuẩn SEO:
- Xác định URL quan trọng cần crawl
Bao gồm trang chủ, trang dịch vụ, danh mục, sản phẩm, bài blog, landing page SEO. - Xác định URL không cần crawl
Ví dụ: /wp-admin/, /cart/, /checkout/, /search/, URL filter, URL sort, parameter URL. - Viết cú pháp rõ ràng
Tránh dùng lệnh quá rộng như Disallow: / nếu website đang chạy chính thức. - Thêm sitemap XML
Nên khai báo sitemap để bot dễ tìm các URL quan trọng. - Upload file lên thư mục gốc
File phải truy cập được tại: https://domain.com/robots.txt - Kiểm tra sau khi cập nhật
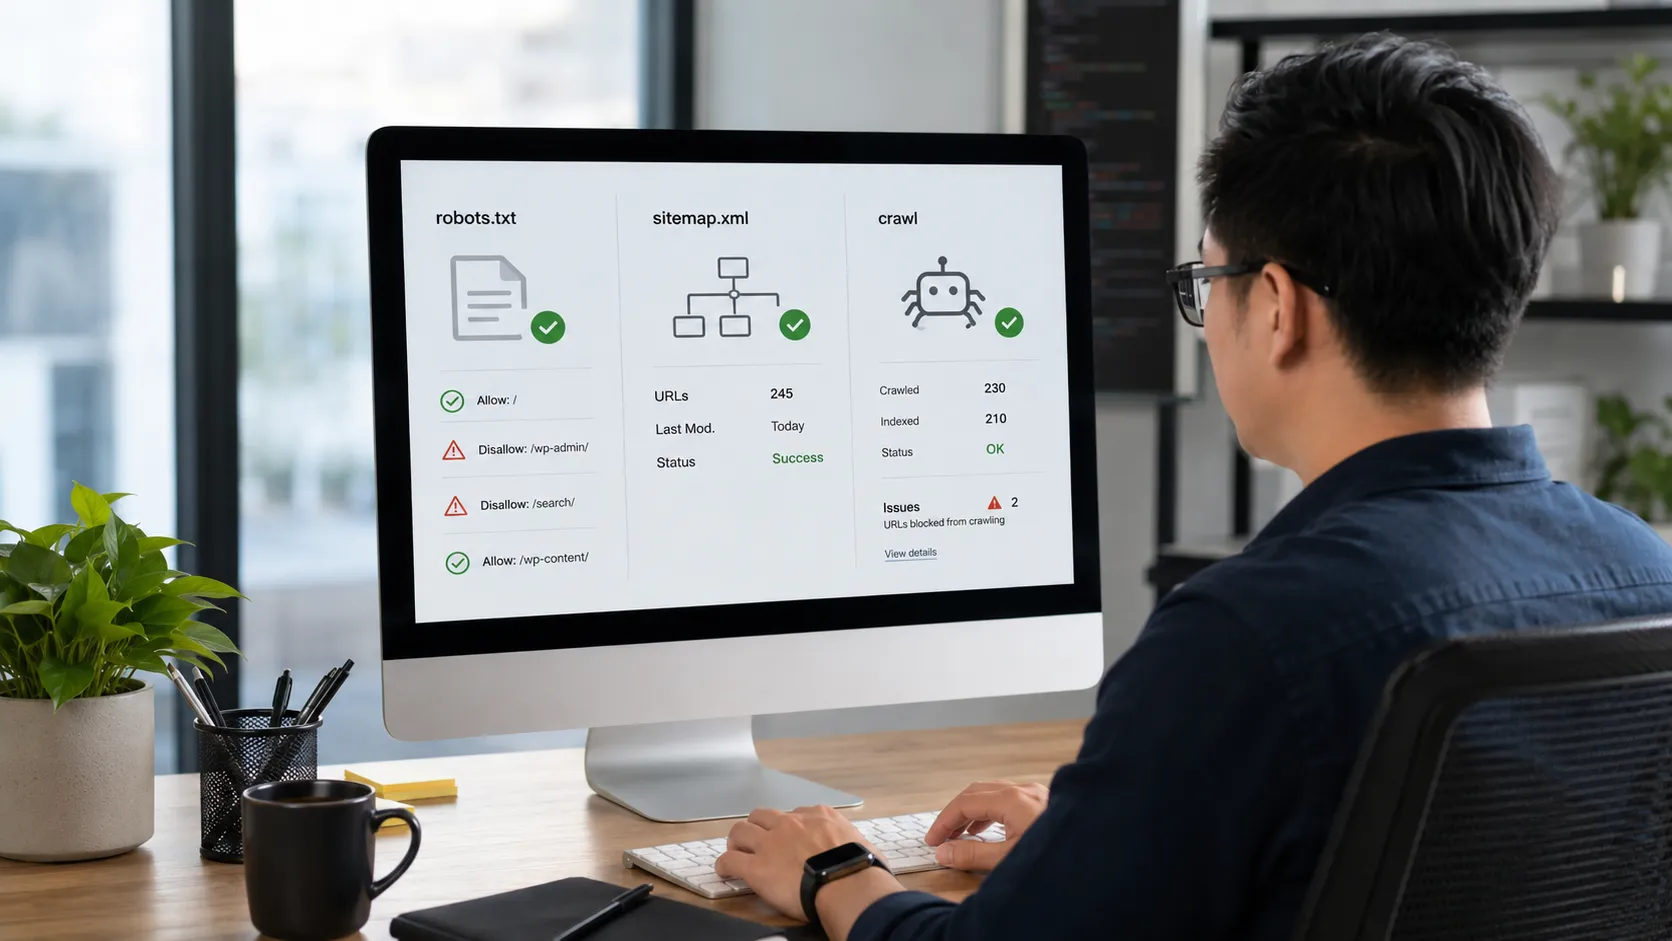
Dùng Google Search Console, URL Inspection hoặc Screaming Frog để kiểm tra URL có bị chặn nhầm không.
Mẫu robots txt cơ bản cho website thông thường:
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
Mẫu cho website bán hàng:
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /*?sort=
Disallow: /*?filter=
Sitemap: https://example.com/sitemap.xml
Với ecommerce, robots txt cần được kiểm tra rất kỹ. Chặn URL filter là tốt, nhưng nếu chặn nhầm danh mục hoặc sản phẩm chính, website có thể mất cơ hội index các trang tạo doanh thu.
Các Lỗi Robots TXT Thường Gặp
Một file robots txt sai có thể gây tác động lớn hơn bạn nghĩ. Đặc biệt khi migrate website, launch web mới hoặc chỉnh sửa technical SEO, đây là khu vực cần kiểm tra đầu tiên.
Các lỗi thường gặp:
| Lỗi | Hậu quả |
| Disallow: / trên website chính | Chặn bot crawl toàn bộ website |
| Chặn CSS, JS, hình ảnh | Google khó render và hiểu trang |
| Dùng robots txt để bảo mật | Bot xấu vẫn có thể bỏ qua quy tắc |
| Không khai báo sitemap | Bot khó khám phá URL quan trọng hơn |
| Copy file từ staging sang production | Website chính có thể bị chặn crawl |
| Dùng wildcard sai | Chặn nhầm nhiều URL quan trọng |
Ví dụ lỗi nghiêm trọng:
User-agent: *
Disallow: /
Dòng này có nghĩa là chặn tất cả bot crawl toàn bộ website. Cấu hình này chỉ nên dùng cho môi trường staging hoặc test, không dùng cho website đang cần SEO.
Best Practices Khi Tối Ưu Robots TXT
Robots txt nên được xem như một phần của technical SEO, không phải file chỉnh một lần rồi bỏ quên. Mỗi khi website thay đổi cấu trúc, thêm bộ lọc, thêm sitemap hoặc migrate, bạn nên kiểm tra lại file này.
Checklist tối ưu robots txt:
- Đặt file đúng tại thư mục gốc của domain.
- Không chặn URL quan trọng cần SEO.
- Không dùng robots txt thay cho noindex.
- Thêm sitemap XML vào cuối file.
- Không chặn CSS, JS, hình ảnh cần render.
- Kiểm tra bằng Google Search Console sau khi chỉnh sửa.
- Với WordPress, nên chặn /wp-admin/ nhưng allow admin-ajax.php.
- Với ecommerce, cần kiểm soát URL filter, sort, parameter cẩn thận.
- Với staging site, nên dùng thêm password thay vì chỉ dựa vào robots txt.
- Kiểm tra file robots txt trước và sau khi launch website.
FAQ Về Robots TXT
Phần FAQ giúp bài viết bao phủ thêm các truy vấn dài và giải đáp nhanh những thắc mắc phổ biến. Đây cũng là cách tốt để tăng độ đầy đủ nội dung mà không làm bài bị lan man.
Robots txt có bắt buộc không?
Không bắt buộc. Nhưng hầu hết website nên có robots txt để hướng dẫn bot và khai báo sitemap.
Robots txt có giúp tăng thứ hạng không?
Không trực tiếp. Nhưng robots txt giúp bot crawl website hiệu quả hơn, từ đó hỗ trợ SEO kỹ thuật.
File robots.txt nằm ở đâu?
File nằm ở thư mục gốc, ví dụ: https://domain.com/robots.txt.
Robots txt khác gì sitemap.xml?
Robots txt hướng dẫn bot nên hoặc không nên crawl đâu. Sitemap.xml liệt kê các URL quan trọng mà bot nên khám phá.
Có nên chặn trang admin bằng robots txt không?
Có thể chặn admin page, nhưng không nên xem robots txt là công cụ bảo mật. Với dữ liệu nhạy cảm, nên dùng xác thực hoặc mật khẩu.
Kết Luận
Robots txt là một phần nhỏ nhưng rất quan trọng trong technical SEO. File này giúp kiểm soát cách Googlebot và các crawler truy cập website, hỗ trợ tối ưu crawl budget, hạn chế URL rác và khai báo sitemap rõ ràng hơn.
Điểm cần nhớ là robots txt không phải công cụ chặn index tuyệt đối. Nếu muốn một trang không xuất hiện trên Google, bạn cần dùng noindex hoặc giải pháp phù hợp hơn. Ngược lại, nếu muốn hướng bot tập trung vào những khu vực quan trọng, một file robots txt được cấu hình đúng sẽ giúp website vận hành SEO hiệu quả và an toàn hơn.
Nếu website của bạn đang gặp lỗi index, crawl budget, URL rác hoặc traffic organic giảm sau khi chỉnh sửa kỹ thuật, Tandigi Agency có thể hỗ trợ audit robots txt, sitemap, internal link và toàn bộ nền tảng technical SEO trong chiến lược marketing
Thông tin liên hệ:
🏢 Địa chỉ: 02 Đường số 7, Khu Đô Thị Vạn Phúc- Tp.Thủ Đức
🌐 Website: https://tandigi.com
🌐 Fanpage: https://www.facebook.com/tandigiagency/
📩 Email: [email protected]
📞 Số điện thoại: 0908 364 575

Tân Nguyễn là CEO Tandigi, với hơn 15 năm kinh nghiệm trong lĩnh vực Digital Marketing. Anh đã tư vấn và triển khai chiến lược tiếp thị số cho hàng trăm doanh nghiệp trong và ngoài nước. Với tư duy chiến lược và sự am hiểu sâu sắc về thị trường, Tân Nguyễn là một trong những chuyên gia hàng đầu trong ngành.